T2D 리스크 스크리너
한국 국민건강보험공단(NHIS) 데이터로 만든 보정된 당뇨 사전 스크리닝 도구입니다. 2형 당뇨가 있을 가능성이 높은 환자를 가려내 증상이 나타나기 전에 공복혈당(FPG) 검사를 받도록 안내합니다.
한눈에 보기
- 분야: 임상·헬스케어 ML, 한국 건강보험공단(NHIS) 건강검진 공개 데이터(약 100만 명) 기반 학습
- 역할: 4인 팀 과제 프로젝트 팀장, 2026년 봄 학기 (데이터 파이프라인·모델링·배포 전담)
- 기술 스택: Python, CatBoost, scikit-learn, SHAP, FastAPI, Pydantic v2, Vanilla JS + Plotly
- 핵심 지표: ROC-AUC 0.816 | 운영 임계값에서 민감도(sensitivity) ≥ 85%
- 상태: 완료 (tysonjohnson.dev/t2d 라이브 데모)
문제 / 배경
2형 당뇨병 환자 중 약 30~40%는 진단받지 못한 채 지내고 있습니다. 한국 국민건강보험공단(NHIS)은 매년 성인 가입자 약 100만 명을 대상으로 건강검진을 실시하고, 활력징후와 체성분, 선택적 검사 결과를 수집합니다. 하지만 이 데이터는 임상의가 이상 수치 하나를 우연히 발견하지 않는 한 당뇨 의뢰로 이어지지 않는 경우가 대부분입니다. 허리-키 비율, 혈압, 간 효소, 지질 비율, 신장 지표 같은 신호는 이미 건강검진에 담겨 있습니다. 이 신호만으로 미진단 당뇨 위험이 높은 환자를 찾아내 공복혈당(FPG)이나 당화혈색소(HbA1c) 확인 검사로 연결할 수 있는지 확인하고 싶었습니다.
접근 방식
2024년 NHIS 건강검진 공개 CSV 파일(약 91 MB, 약 100만 행)을 수집하여 원시 검진 항목에서 40개의 특징을 엔지니어링했습니다. 파생 체성분 지수(BMI, 허리-키 비율, 체중 보정 허리 지수), 혈역학 복합 지수(맥압, 평균 동맥압), 간 기능 비율(AST/ALT), 우편향 검사 수치의 로그 변환(GGT, 중성지방, 간 효소), 전체 지질 패널 비율 등이 포함됩니다. 선택적 검사 항목별로 이진 결측 플래그를 추가하여 값뿐만 아니라 결측 여부에서도 학습할 수 있도록 했습니다.
데이터셋은 클래스 불균형 상태입니다(양성 약 7.9%, 약 12:1 비율). 층화 60/20/20 분할을 적용하고, 리샘플링 대신 CatBoost 내부에서 역 클래스 빈도 가중치를 사용하여 보정 목표값의 정직성을 유지했습니다.
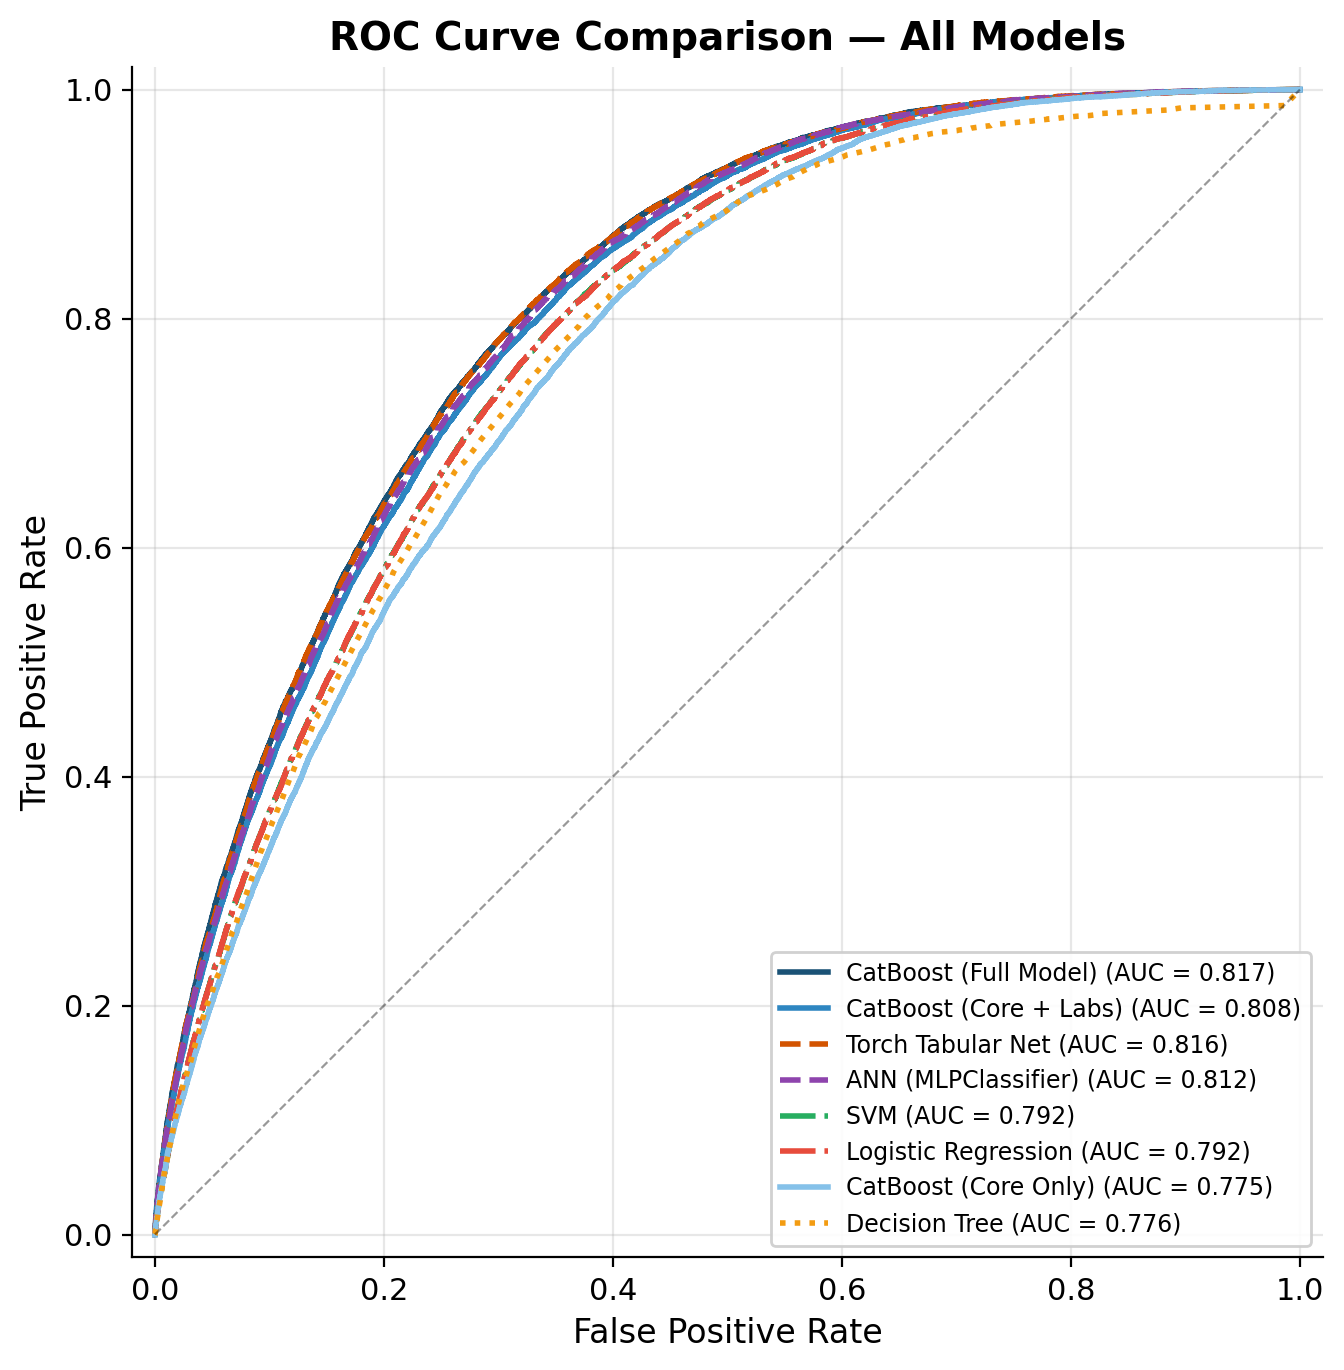
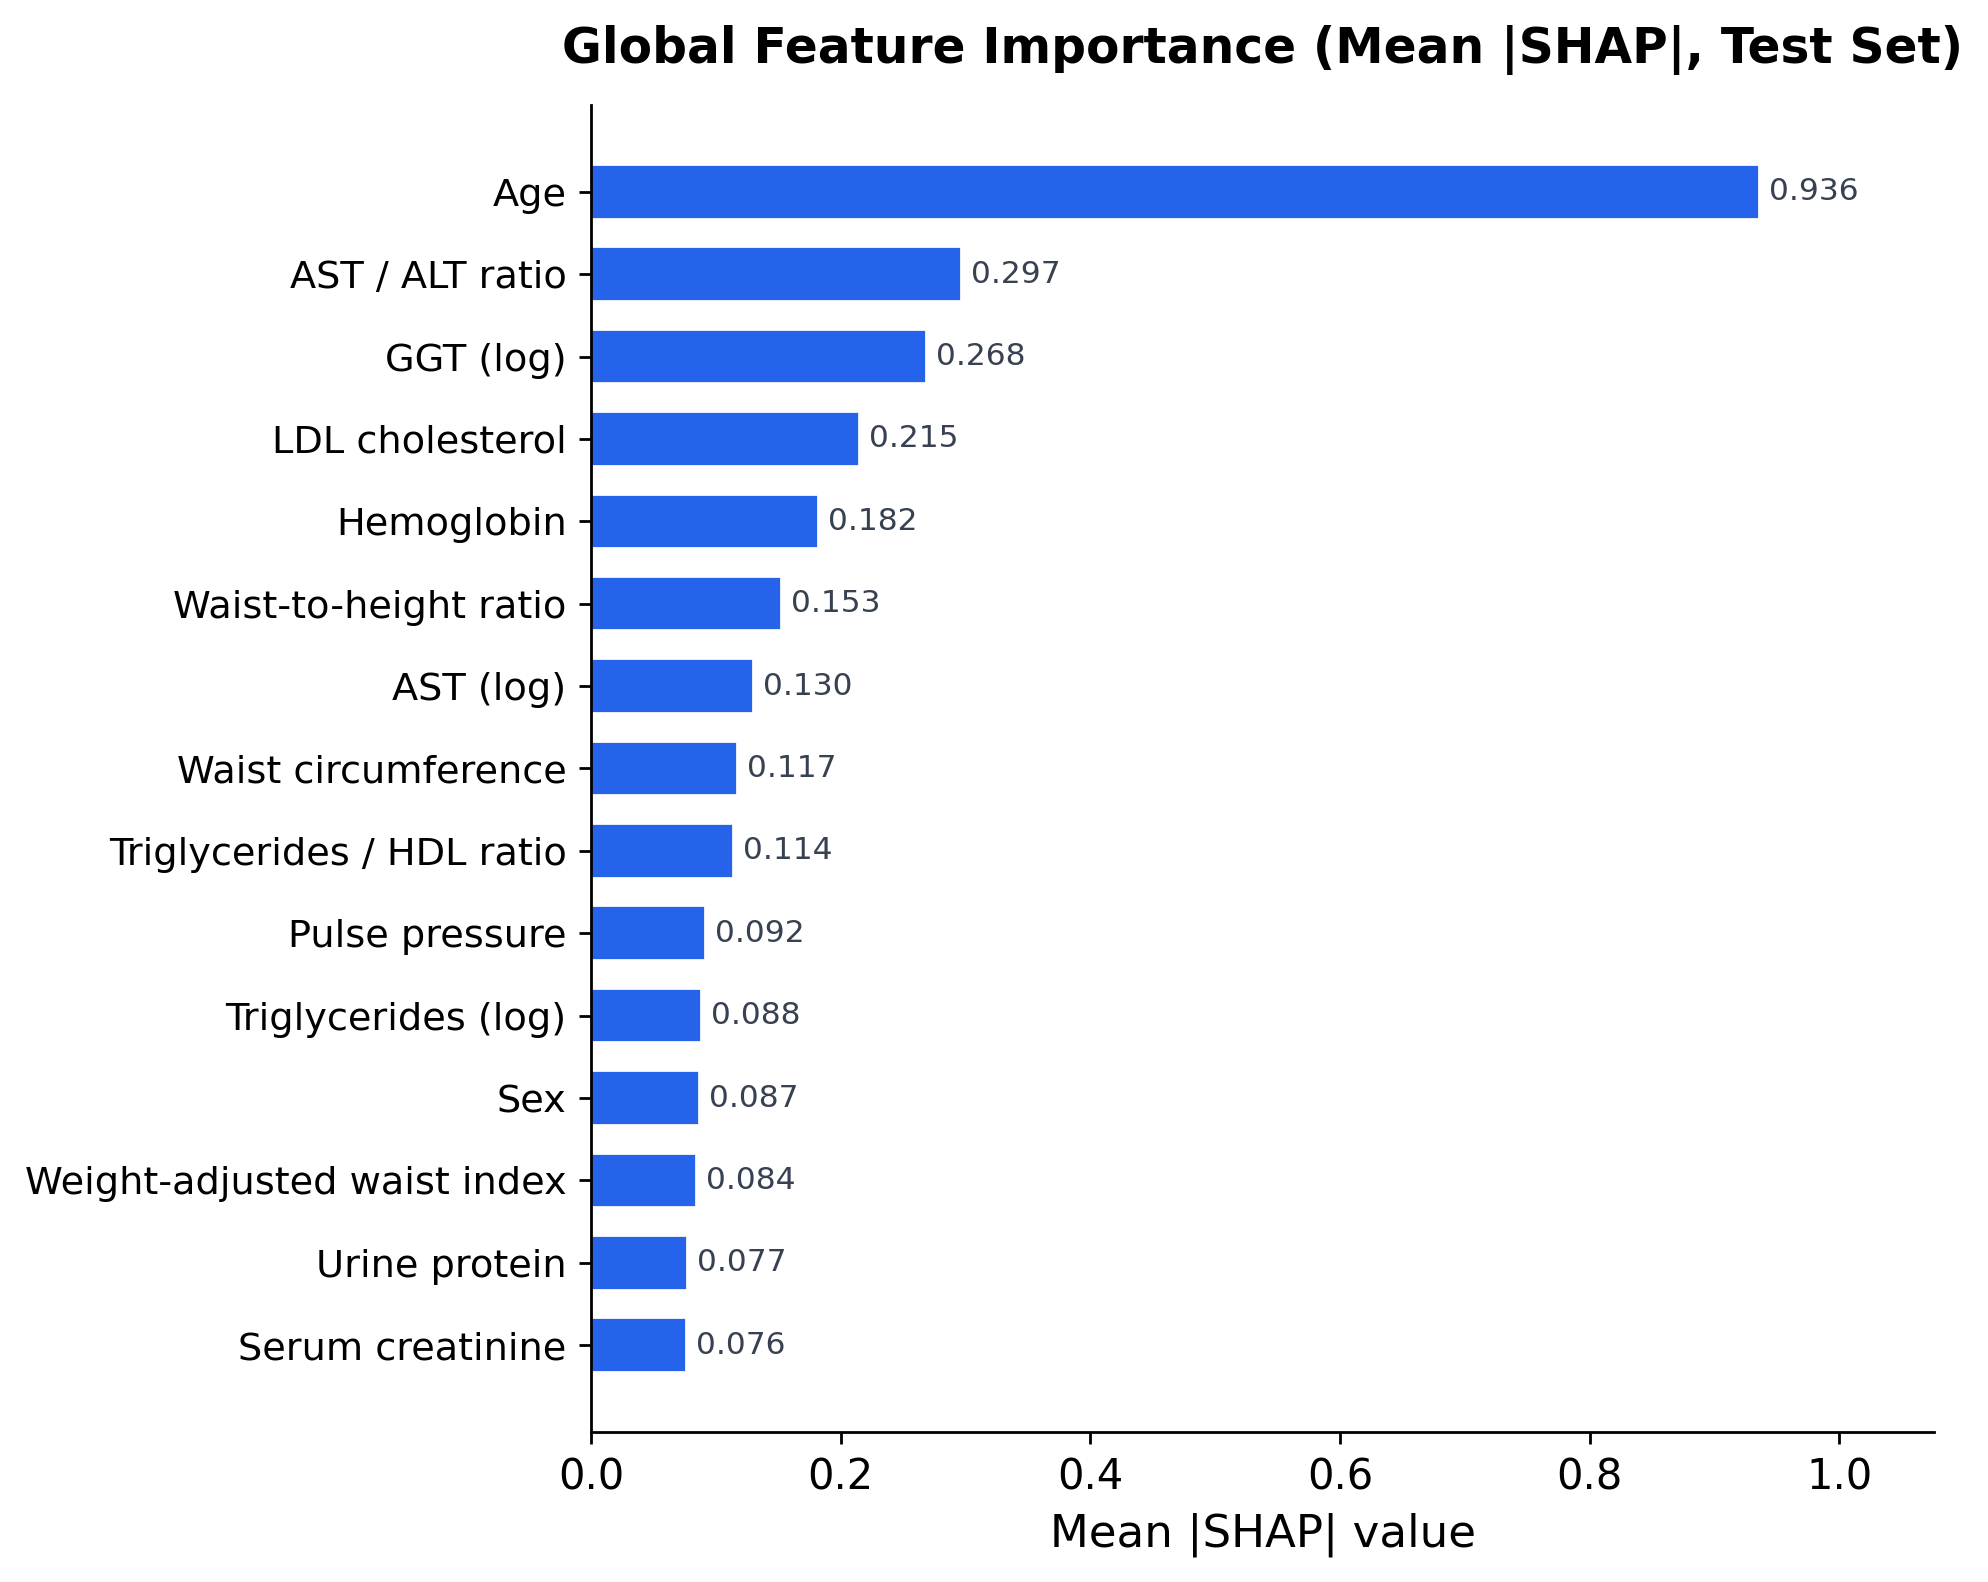
동일한 홀드아웃 테스트 분할에서 CatBoost, PyTorch 표 형식 신경망, sklearn MLP, 로지스틱 회귀, RBF 커널 SVM, 의사결정 트리까지 여섯 개 모델을 비교했습니다. CatBoost와 PyTorch 신경망은 ROC-AUC에서 사실상 동점이었습니다(0.817 vs. 0.816). 그래도 CatBoost를 선택한 이유는 예측마다 정확하고 빠른 SHAP 값을 네이티브로 계산하고 CPU에서도 비용 부담 없이 돌아가기 때문입니다. 신경망에서 같은 수준의 설명을 얻으려면 느리고 근사적인 대체 방법(KernelSHAP)이 필요했을 것입니다. 임상 스크리닝 도구는 모든 양성 판정에 투명한 근거가 있어야 합니다.
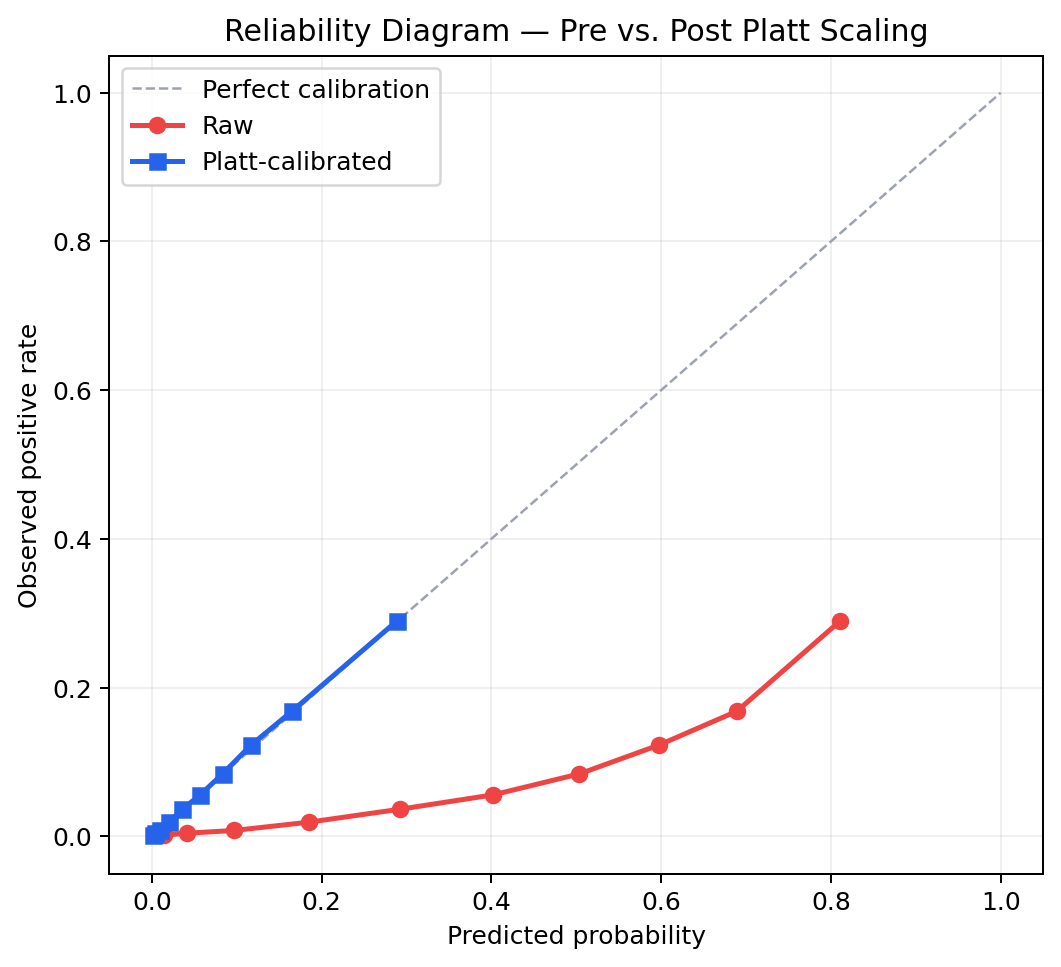
CatBoost 원시 시그모이드 출력은 순위는 잘 매겼지만 7.9%의 기저율 대비 낮은 확률에서 과신(overconfident)하는 경향이 있었습니다. 검증셋 로짓에 Platt 스케일링(1-파라미터 로지스틱 회귀 적합)을 적용하여 경험적 양성률에 맞게 확률을 보정했습니다. 운영 임계값(0.066)은 민감도 85% 이상을 달성하는 최솟값으로 검증셋에서 튜닝되었으며, 이는 비대칭 임상 비용을 반영합니다: 스크리닝을 놓치면 환자가 FPG 검사를 받을 기회를 잃게 됩니다.
서빙 레이어는 커밋된 모델 번들(약 1.6 MB:
catboost_model.cbm, calibrator.pkl, metadata.json,
global_shap.json)을 기반으로 하는 FastAPI 앱입니다.
Vanilla JS 싱글 페이지 프론트엔드가 검진 입력값을 수집하고 API를 호출하여
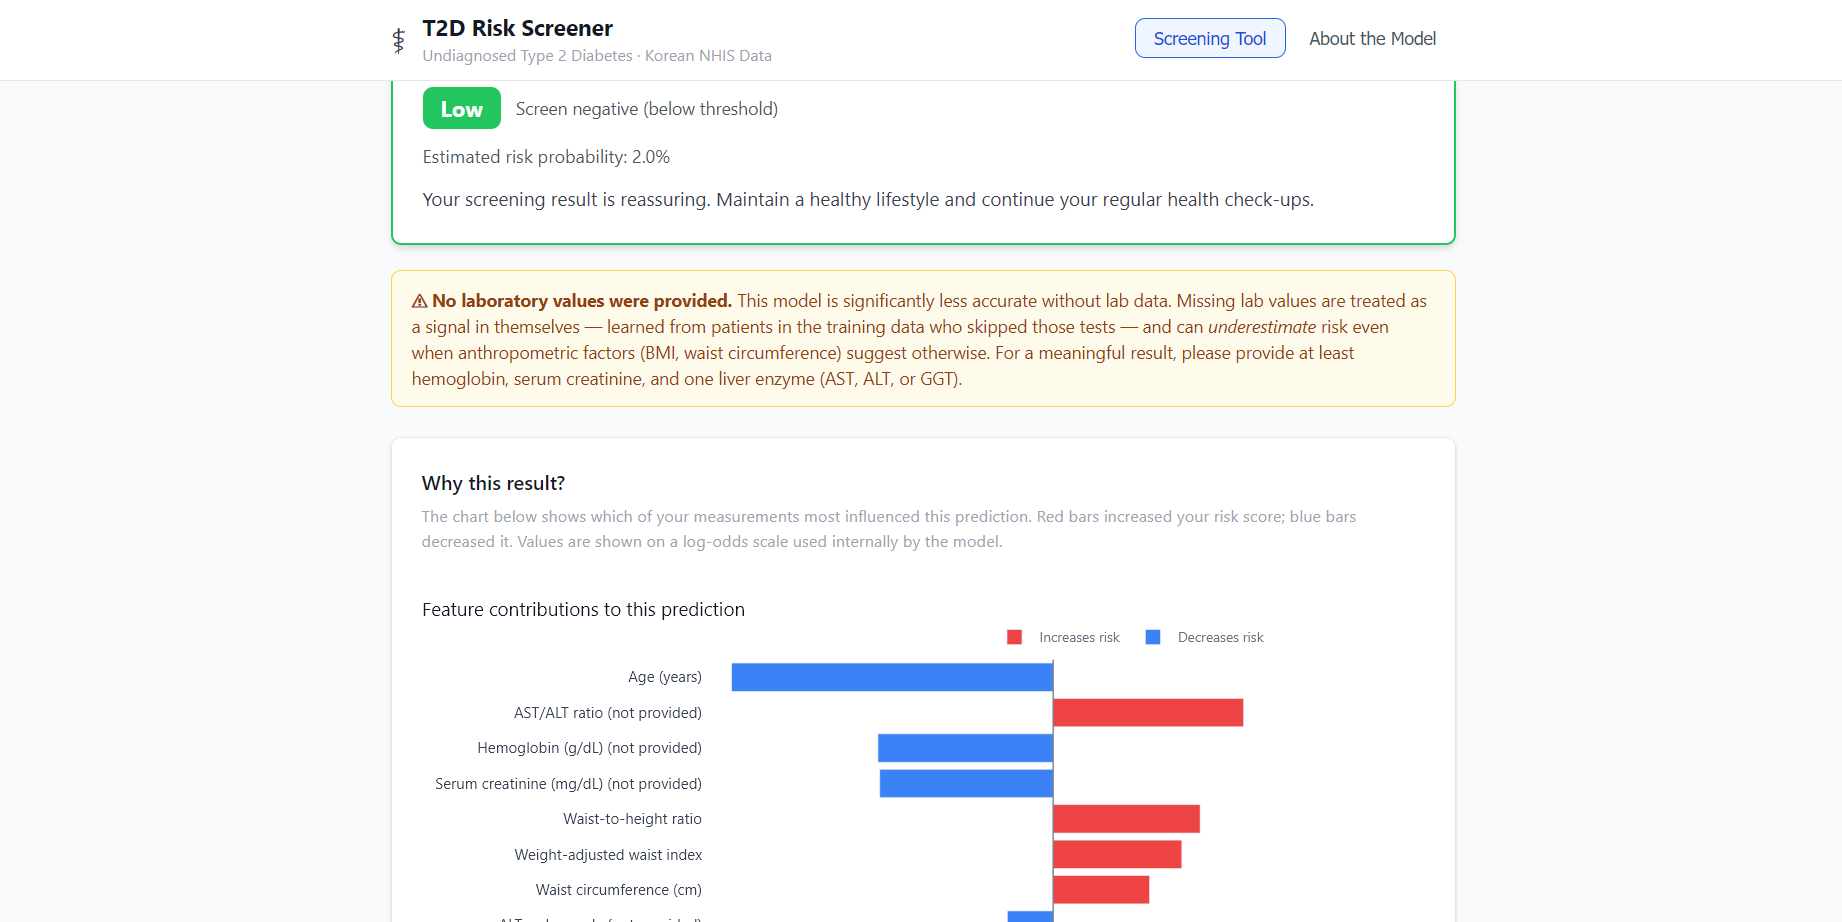
보정된 확률, 위험 등급, 예측별 SHAP 워터폴 차트(Plotly), 임상 권고사항을 렌더링합니다.
결과
홀드아웃 20% 테스트 슬라이스(n ≈ 200k)에서 평가한 결과:
| 지표 | 값 |
|---|---|
| ROC-AUC | 0.816 |
| PR-AUC (Average Precision) | 0.273 |
| Brier 점수 | 0.064 |
| 운영 임계값 | 0.066 (민감도 ≥ 85%) |
| 운영 임계값에서의 NPV | 0.98 |
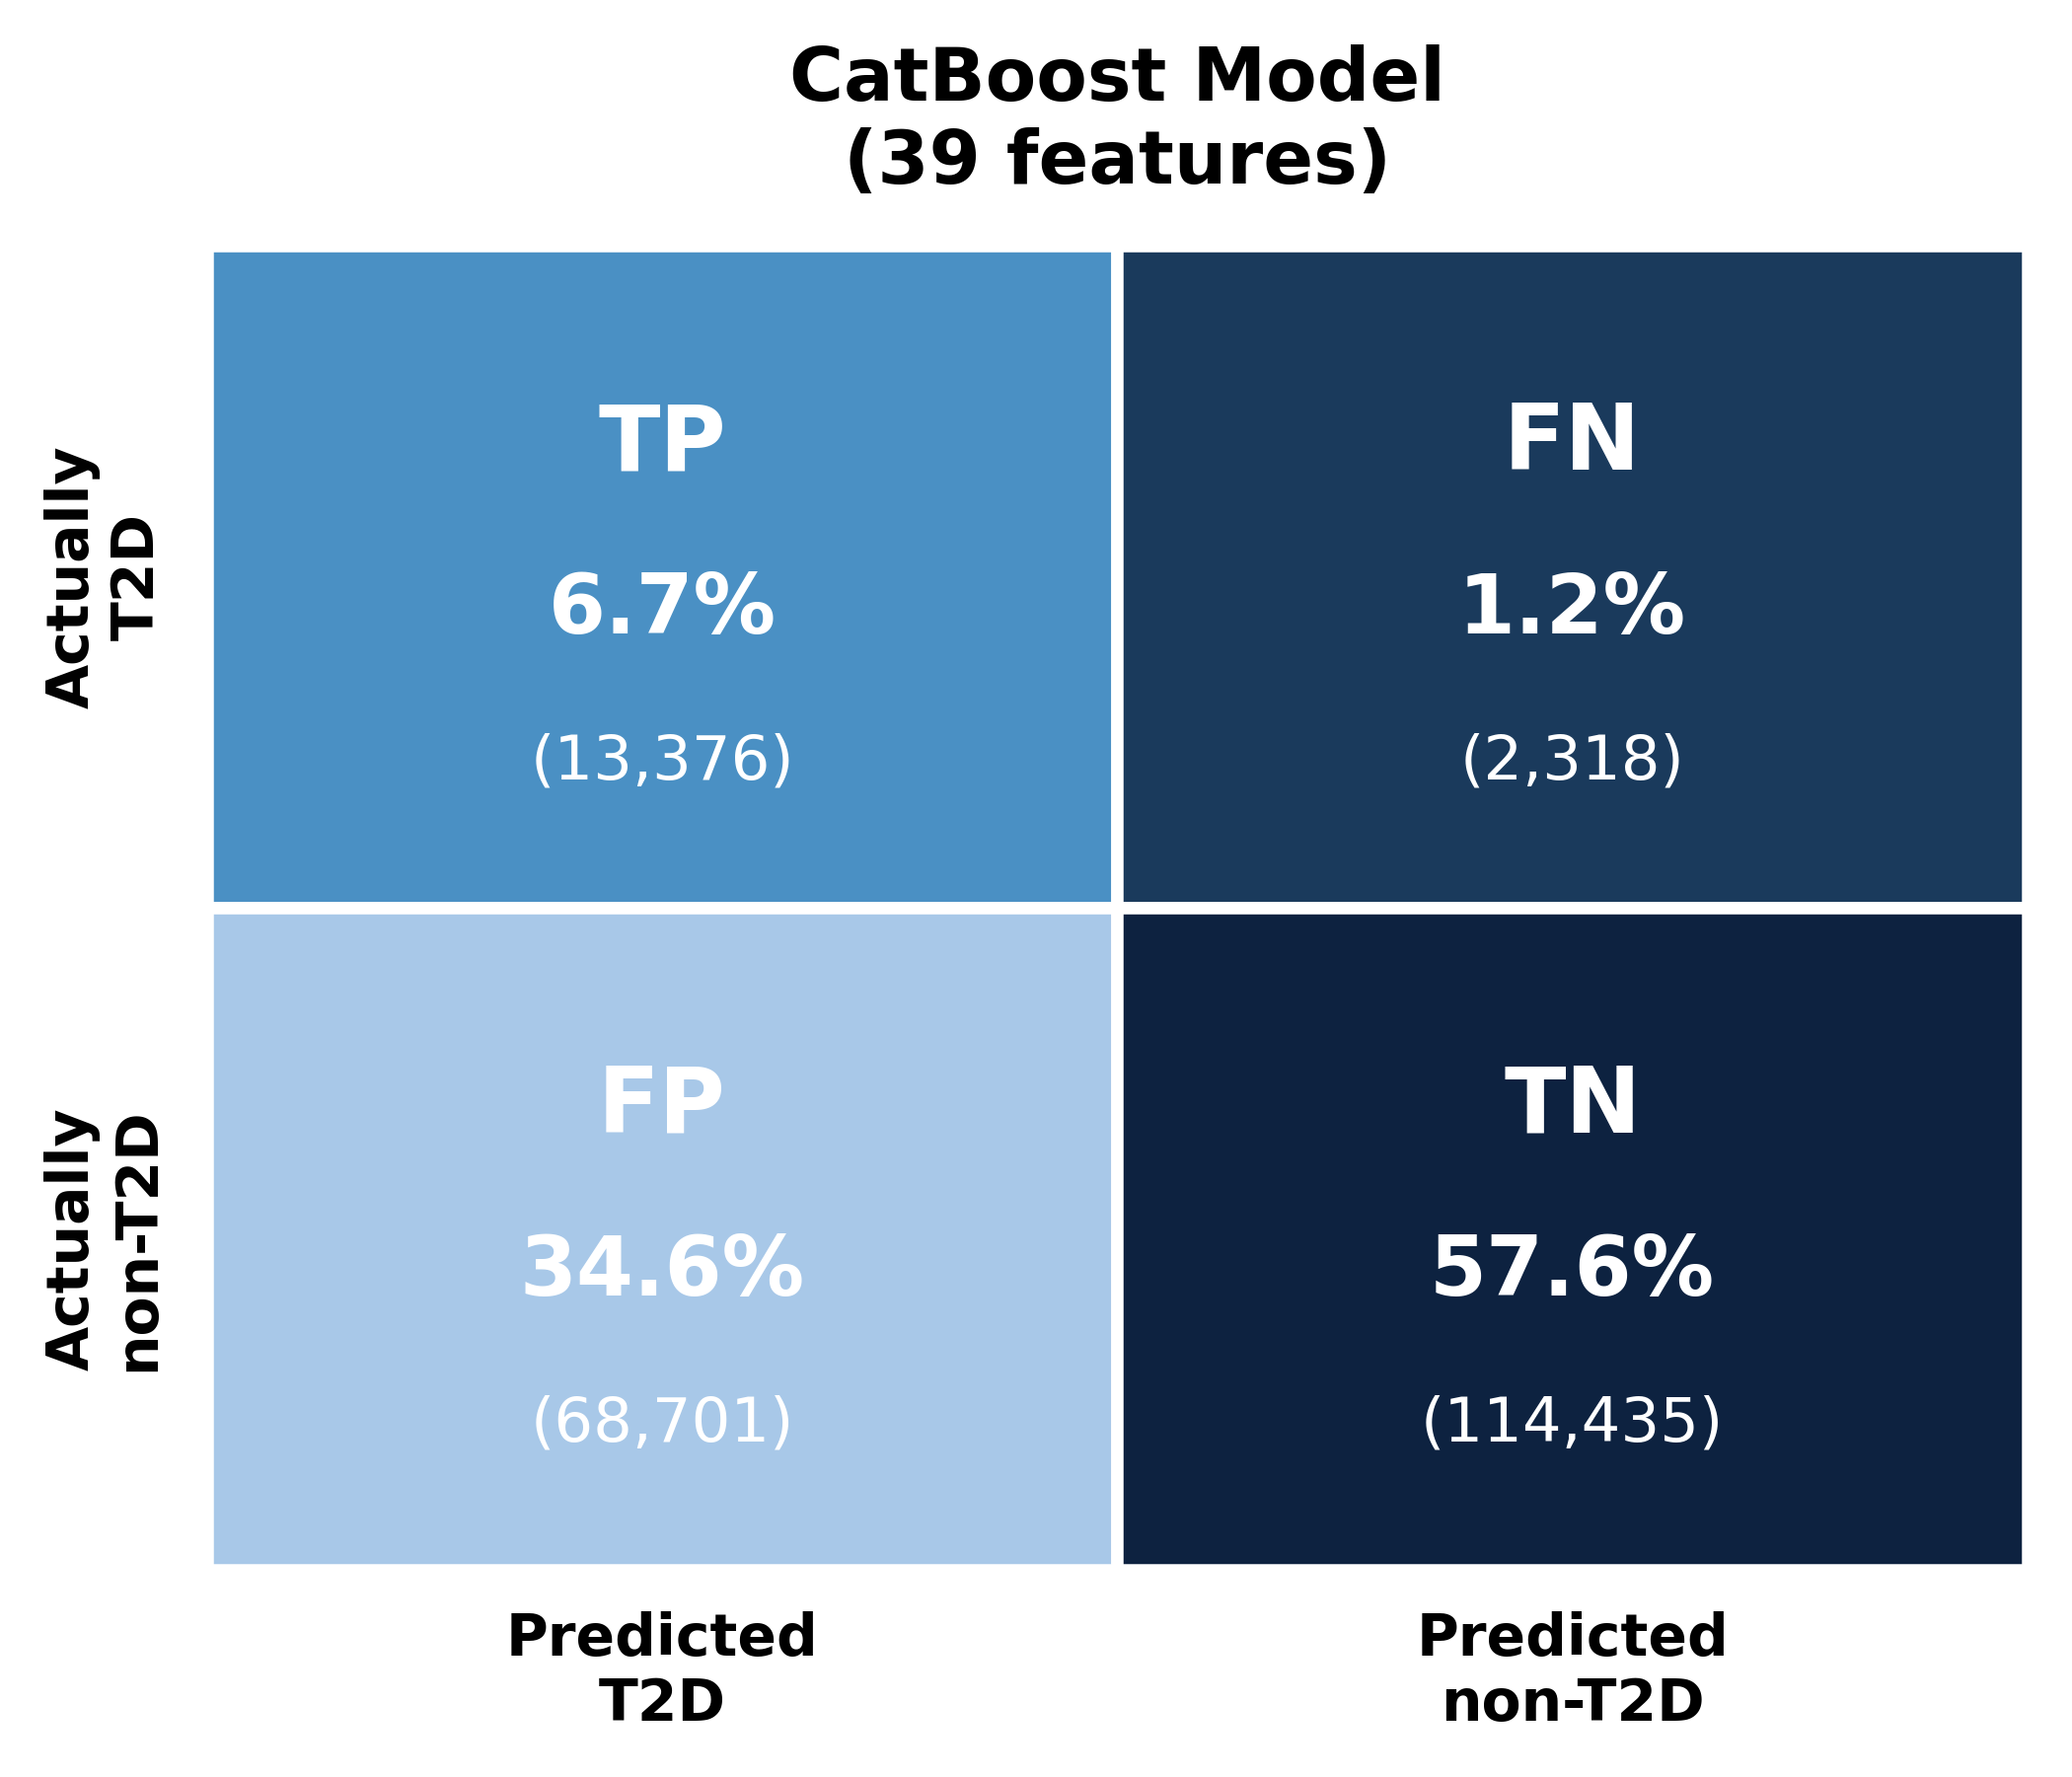
가장 자랑스러운 지표는 NPV입니다. 0.066 임계값에서 0.98로, 테스트 구간에서 진음성 114,435건 대비 위음성은 2,318건에 불과합니다. 도구가 저위험이라고 판정했을 때 그 판정이 맞을 확률이 98%라는 뜻입니다. 사람을 안전하게 배제하는 것이 스크리닝 도구의 핵심 역할입니다.
주요 결정 사항 / 학습 내용
FPG를 특징에서 빼는 것은 타협할 수 없는 원칙이었습니다.
FPG 자체가 레이블을 정의하는 값이기 때문에(has_diabetes = FPG ≥ 126 mg/dL), 이를 포함하면 모델이 레이블을 그대로 되풀이하는 것에 불과해집니다.
실제 엔지니어링의 핵심은 간접적인 대사 지표만으로 강한 신호를 만들어내는 데 있었습니다.
통계적으로 동점인 PyTorch 신경망 대신 CatBoost를 선택했습니다. 제품에 무엇이 필요한지를 기준으로 내린 결정입니다. AUC 차이는 0.001에 불과했지만 GPU 없이 빠르고 정확한 예측별 설명을 내놓는 쪽은 CatBoost뿐이었습니다. 임상용 점수는 설명이 붙지 않으면 사실상 쓸모가 없습니다.
보정도 같은 이유로 중요했습니다. 순위는 잘 매기는 모델이라도 실제 기저율이 7.9%인데 0.4를 출력하면, 임상의는 그 숫자를 보는 순간 신뢰를 거둡니다. Platt 스케일링은 홀드아웃 로짓에 로지스틱 회귀 하나를 적용하는 작은 작업입니다. 그래도 이 작업 덕분에 화면에 표시되는 확률을 실제 확률로 읽을 수 있습니다.
한계점
이 프로젝트의 범위와 한계에 대해 솔직하게 명시합니다.
- 단일 한국 코호트, 단일 연도. 모든 학습 데이터는 2024년 NHIS 무작위 표본에서 가져온 것입니다. 다른 집단, 연도, 의료 시스템에서의 성능은 검증되지 않았습니다.
- 레이블 노이즈. 한 시점에서의 FPG ≥ 126 mg/dL는 이미 진단받았지만 혈당 조절이 불량한 일부 T2D 환자를 "미진단"으로 잘못 분류할 수 있습니다. NHIS 공개 데이터에는 치료 이력이 포함되지 않기 때문입니다.
- 선택적 검사의 선택 편향. 지질 및 간 효소 패널은 임상의 재량으로 처방되었습니다. 검사가 누락된 환자는 평균적으로 검사를 받은 환자보다 건강하므로, 모델은 검사 결측을 경미한 건강 신호로 학습합니다. 검사 항목이 모두 공란인 경우 위험도가 과소평가될 수 있으며, 프론트엔드에 경고 문구가 표시됩니다.
- 연령 구간의 조잡함. NHIS는 연령을 5년 단위 구간으로만 공개하며, 모델은 구간 중앙값을 사용합니다.
- 임상 검증 미완료. 이 프로젝트는 연구 포트폴리오 작업입니다. 진단 도구가 아니며 전향적 검증을 거치지 않았습니다.
기술 스택
- 모델링: Python, CatBoost, scikit-learn (Platt 보정, 층화 분할, 평가)
- 설명 가능성: SHAP (CatBoost 네이티브 정확 SHAP)
- API: FastAPI, Pydantic v2, Uvicorn
- 프론트엔드: Vanilla JS, Plotly (SHAP 워터폴 차트)
- 데이터: 한국 NHIS 2024 건강검진 데이터 (data.go.kr)
링크
- GitHub: github.com/tysonjohnsondev/t2d-screener
- 라이브 데모: tysonjohnson.dev/t2d
- 데이터셋: 한국 NHIS 2024 건강검진 데이터